Réponse courte (TL;DR)
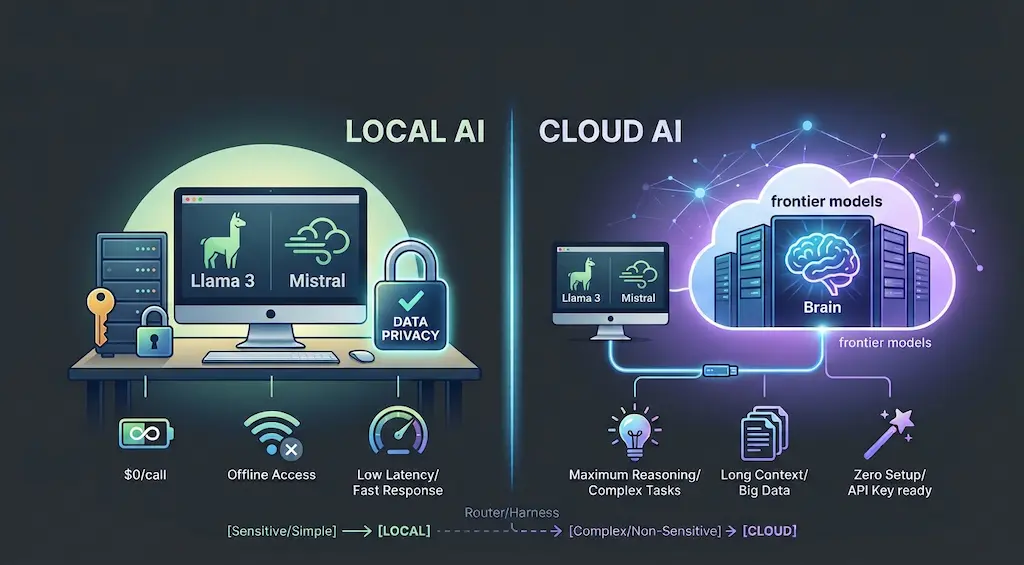
Exécutez les modèles d’IA en local quand la confidentialité, un coût prévisible ou l’accès hors ligne comptent plus que la capacité brute. Utilisez des modèles cloud quand vous avez besoin du meilleur raisonnement, d’un long contexte ou d’une mise en route sans configuration. Pour la plupart des développeurs, la meilleure réponse est hybride : des modèles locaux pour le travail courant et sensible, et des modèles cloud pour les problèmes difficiles, le tout derrière un seul harness.
Introduction
En tant que product engineer travaillant surtout avec React, Next.js, Laravel et TypeScript, et de plus en plus avec les outils d’IA, je dois régulièrement choisir entre exécuter un modèle sur ma propre machine et appeler une API cloud. Cet article explique comment je décide, et comment combiner les deux sans compliquer votre stack.
Qu’est-ce que l’IA locale ?
L’IA locale signifie que le modèle s’exécute sur du matériel que vous contrôlez, comme votre portable, une station de travail ou votre propre serveur, et non derrière l’API d’un fournisseur. Vous téléchargez des modèles à poids ouverts, comme les variantes de Llama, Qwen, Mistral, Gemma ou DeepSeek, et vous les servez avec un runtime tel qu’Ollama, LM Studio, llama.cpp ou vLLM.
Vos prompts et vos données ne quittent jamais votre machine, et chaque appel ne coûte rien de plus que votre matériel et votre électricité.
Une réserve : vérifiez la licence de chaque modèle. « Poids ouverts » ne veut pas toujours dire open source, ni gratuit pour un usage commercial.
Qu’est-ce que l’IA cloud ?
L’IA cloud signifie que vous appelez un modèle hébergé via une API, par exemple celle d’OpenAI, d’Anthropic, de Google ou d’autres fournisseurs. Vous payez au token, vous accédez aux modèles de pointe les plus performants, et vous ne gérez aucune infrastructure.
Vous échangez un peu de contrôle contre de la capacité et de la commodité.
IA locale vs IA cloud : comparaison côte à côte
| Critère | IA locale | IA cloud |
|---|---|---|
| Confidentialité | Les données restent sur votre machine | Les données sont envoyées au fournisseur ; la conservation dépend de ses conditions |
| Modèle de coût | Matériel au départ, puis presque rien par appel | Paiement au token, qui augmente avec l’usage |
| Capacité | Bon pour des tâches ciblées, plus faible en raisonnement complexe | Meilleur raisonnement et contexte le plus long |
| Vitesse | Dépend de votre matériel | Rapide et constant, plus la latence réseau |
| Usage hors ligne | Fonctionne sans internet | Nécessite une connexion |
| Mise en place | Vous installez, mettez à jour et réglez les modèles | Une clé API et c’est parti |
| Montée en charge | Limitée par vos machines | Évolue avec votre budget |
Quand faut-il exécuter les modèles en local ?
Exécutez en local quand la tâche est répétitive, sensible ou à gros volume, et qu’un modèle plus petit la gère bien. Ce sont les cas où l’IA locale se justifie :
- Embeddings et recherche sémantique. Les modèles d’embedding sont petits et rapides, et vous pouvez avoir des milliers de documents à vectoriser. Les exécuter en local garde le coût constant.
- Documents privés. Contrats clients, code interne, données financières ou tout ce qui est sous NDA peuvent être résumés, classés ou consultés sans quitter votre machine. Rien n’est envoyé à un tiers, ce qui rend aussi les règles de protection des données comme le RGPD plus simples à gérer.
- Outils de développement. Suggestions de messages de commit, explications rapides de code, résumés de logs et génération de données de test n’ont pas besoin d’un modèle de pointe.
- Agents simples. Les agents qui classent, extraient ou routent, avec des entrées et des sorties claires, fonctionnent souvent bien sur un petit modèle local.
- Travail hors ligne et en périphérie. Quand vous voyagez, avez une connexion faible ou construisez pour un environnement sans internet fiable.
Quand l’IA cloud reste-t-elle gagnante ?
Utilisez des modèles cloud quand la qualité sur les problèmes difficiles compte plus que le coût ou la confidentialité. Plus précisément :
- Raisonnement complexe en plusieurs étapes, décisions d’architecture et débogage sur de grandes bases de code.
- Travail en long contexte, comme lire un dépôt entier ou une longue spécification en une seule passe.
- Fonctionnalités en production où vos utilisateurs attendent la meilleure réponse à chaque fois.
- Prototypage, quand vous voulez tester une idée aujourd’hui sans passer l’après-midi à régler un modèle.
Si une mauvaise réponse coûte cher, commencez par le cloud.
Une configuration de départ pratique pour l’IA locale
Le moyen le plus rapide de commencer est un runtime local avec une API compatible OpenAI, afin que votre code existant fonctionne avec les modèles locaux comme avec les modèles cloud. Une configuration simple ressemble à ceci :
- Installez un runtime. Ollama est le plus simple pour démarrer. LM Studio est un bon choix si vous préférez une interface de bureau.
- Téléchargez un petit modèle généraliste et un modèle d’embedding. Commencez avec un modèle quantifié de 7 à 8 milliards de paramètres. Il demande généralement environ 6 à 8 Go de RAM, donc 16 Go de RAM est confortable sur un portable récent. Ne passez à plus gros que si la qualité ne suffit pas.
- Utilisez le point d’accès compatible OpenAI. Ollama en expose un sur
http://localhost:11434/v1, ce qui permet au même SDK que celui du cloud de pointer vers votre machine. - Mesurez avant de vous engager. Passez vos vraies tâches dans le modèle local et comparez le résultat avec un modèle cloud avant de basculer quoi que ce soit.
Le schéma hybride : router les tâches dans un seul harness
La meilleure configuration n’est ni locale ni cloud. C’est un routeur qui envoie chaque tâche au modèle le moins cher capable de la traiter correctement. C’est là qu’un harness IA devient rentable. Si ce terme est nouveau pour vous, je l’explique dans Harness IA, agent IA et orchestration IA : quelle différence ?.
Voici un exemple TypeScript minimal. Les noms de modèles viennent de variables d’environnement, ce qui vous permet d’utiliser les modèles locaux et cloud de votre choix :
import OpenAI from "openai";

const local = new OpenAI({
  baseURL: "http://localhost:11434/v1",
  apiKey: "ollama", // required by the SDK, ignored by Ollama
});

const cloud = new OpenAI({
  apiKey: process.env.OPENAI_API_KEY,
});

const LOCAL_MODEL = process.env.LOCAL_MODEL!;
const CLOUD_MODEL = process.env.CLOUD_MODEL!;

type Task = {
  prompt: string;
  sensitive: boolean;
  complex: boolean;
};

async function ask(client: OpenAI, model: string, prompt: string) {
  const res = await client.chat.completions.create({
    model,
    messages: [{ role: "user", content: prompt }],
  });
  return res.choices[0].message.content ?? "";
}

export async function run(task: Task, isValid: (answer: string) => boolean) {
  const useLocal = task.sensitive || !task.complex;

  if (!useLocal) return ask(cloud, CLOUD_MODEL, task.prompt);

  const answer = await ask(local, LOCAL_MODEL, task.prompt);
  if (isValid(answer)) return answer;

  if (task.sensitive) {
    throw new Error("Local answer failed validation. Review it manually.");
  }
  return ask(cloud, CLOUD_MODEL, task.prompt);
}
Les règles sont simples :
- Les données sensibles restent toujours en local, et ne basculent jamais vers le cloud. Si la réponse locale échoue à la validation, la tâche passe à un humain.
- Les tâches simples vont d’abord en local.
- Les tâches complexes sur des données non sensibles vont directement au cloud.
- Si une tâche non sensible échoue à la validation sur le modèle local, elle est relancée dans le cloud.
Checklist de décision : local ou cloud ?
Posez ces questions pour chaque tâche d’IA de votre produit ou de votre workflow :
- Les données doivent-elles rester privées ? Si oui, choisissez le local.
- Un petit modèle peut-il le faire correctement ? Testez-le. Si oui, choisissez le local.
- Est-ce exécuté des milliers de fois par jour ? Si oui, le local fait généralement économiser de l’argent.
- Une mauvaise réponse coûte-t-elle cher ? Si oui, utilisez le cloud.
- Faut-il un long contexte ou un raisonnement profond ? Si oui, utilisez le cloud.
- Avez-vous besoin que ça fonctionne aujourd’hui, sans configuration ? Si oui, commencez dans le cloud et passez en local plus tard.
FAQ
L’IA locale est-elle suffisante pour coder ?
Pour l’autocomplétion, les explications et les petites refactorisations, souvent oui. Pour le débogage complexe et le travail d’architecture sur une grande base de code, les modèles cloud restent nettement en avance.
Ai-je besoin d’un GPU pour exécuter de l’IA locale ?
Pas pour démarrer. Les petits modèles quantifiés tournent sur de nombreux portables récents, et les Mac Apple Silicon les gèrent bien. Un GPU dédié rend les modèles plus gros et les réponses plus rapides envisageables.
L’IA locale est-elle vraiment gratuite ?
Chaque appel est presque gratuit, mais vous payez le matériel, l’électricité et votre propre temps de mise en place et de maintenance. C’est le moins cher quand votre usage est élevé et régulier.
Puis-je passer d’un modèle local à un modèle cloud sans réécrire le code ?
Oui. Utilisez un runtime avec une API compatible OpenAI et gardez le choix du modèle à un seul endroit, comme le routeur ci-dessus.
Conclusion
L’IA locale et l’IA cloud ne sont pas concurrentes. Ce sont deux outils d’un même système. Gardez le travail privé, répétitif et à gros volume sur votre machine, envoyez les problèmes difficiles au cloud, et confiez le routage à un harness. C’est ainsi que vous obtenez confidentialité, maîtrise des coûts et réponses de premier ordre avec la même stack.
Si vous construisez un système d’IA et souhaitez de l’aide pour concevoir ce type de configuration hybride, contactez-moi.